Ich heiße Johannes Eva und entwickle seit 27 Jahren Websites. Das KI-Schreibranking entstand aus einer Lücke: Keine bestehende Rangliste maß, was mich interessierte, nämlich die Schreibqualität von KI-Modellen auf Deutsch.
Öffentliche Benchmarks konzentrieren sich vor allem auf Code, Mathematik und logisches Denken. Der kleine Teil, der sich mit Schreiben beschäftigt, wird fast immer auf Englisch bewertet. Hier zählt nur die Qualität der erzeugten Texte. Die Aufgaben werden direkt auf Deutsch entwickelt, die Antworten blind verglichen.
Modelle, die auf dem eigenen Rechner laufen, haben einen besonderen Platz. Gemma 4, Qwen 3.6 und 3.8, Ling 3.0 Flash, Muse Glimmer und Granite 4.2 gehören zu den Familien, die mit 🏠 gekennzeichnet sind. Sie wurden lokal in mehreren Quantisierungen ausgeführt, mit aktiviertem und deaktiviertem Reasoning.
Diese Website ist ein persönliches Projekt. Kein Modellentwickler bezahlt mich, und ich habe keinen Grund, ein Modell zu bevorzugen.
Die Rechner für die lokalen Modelle
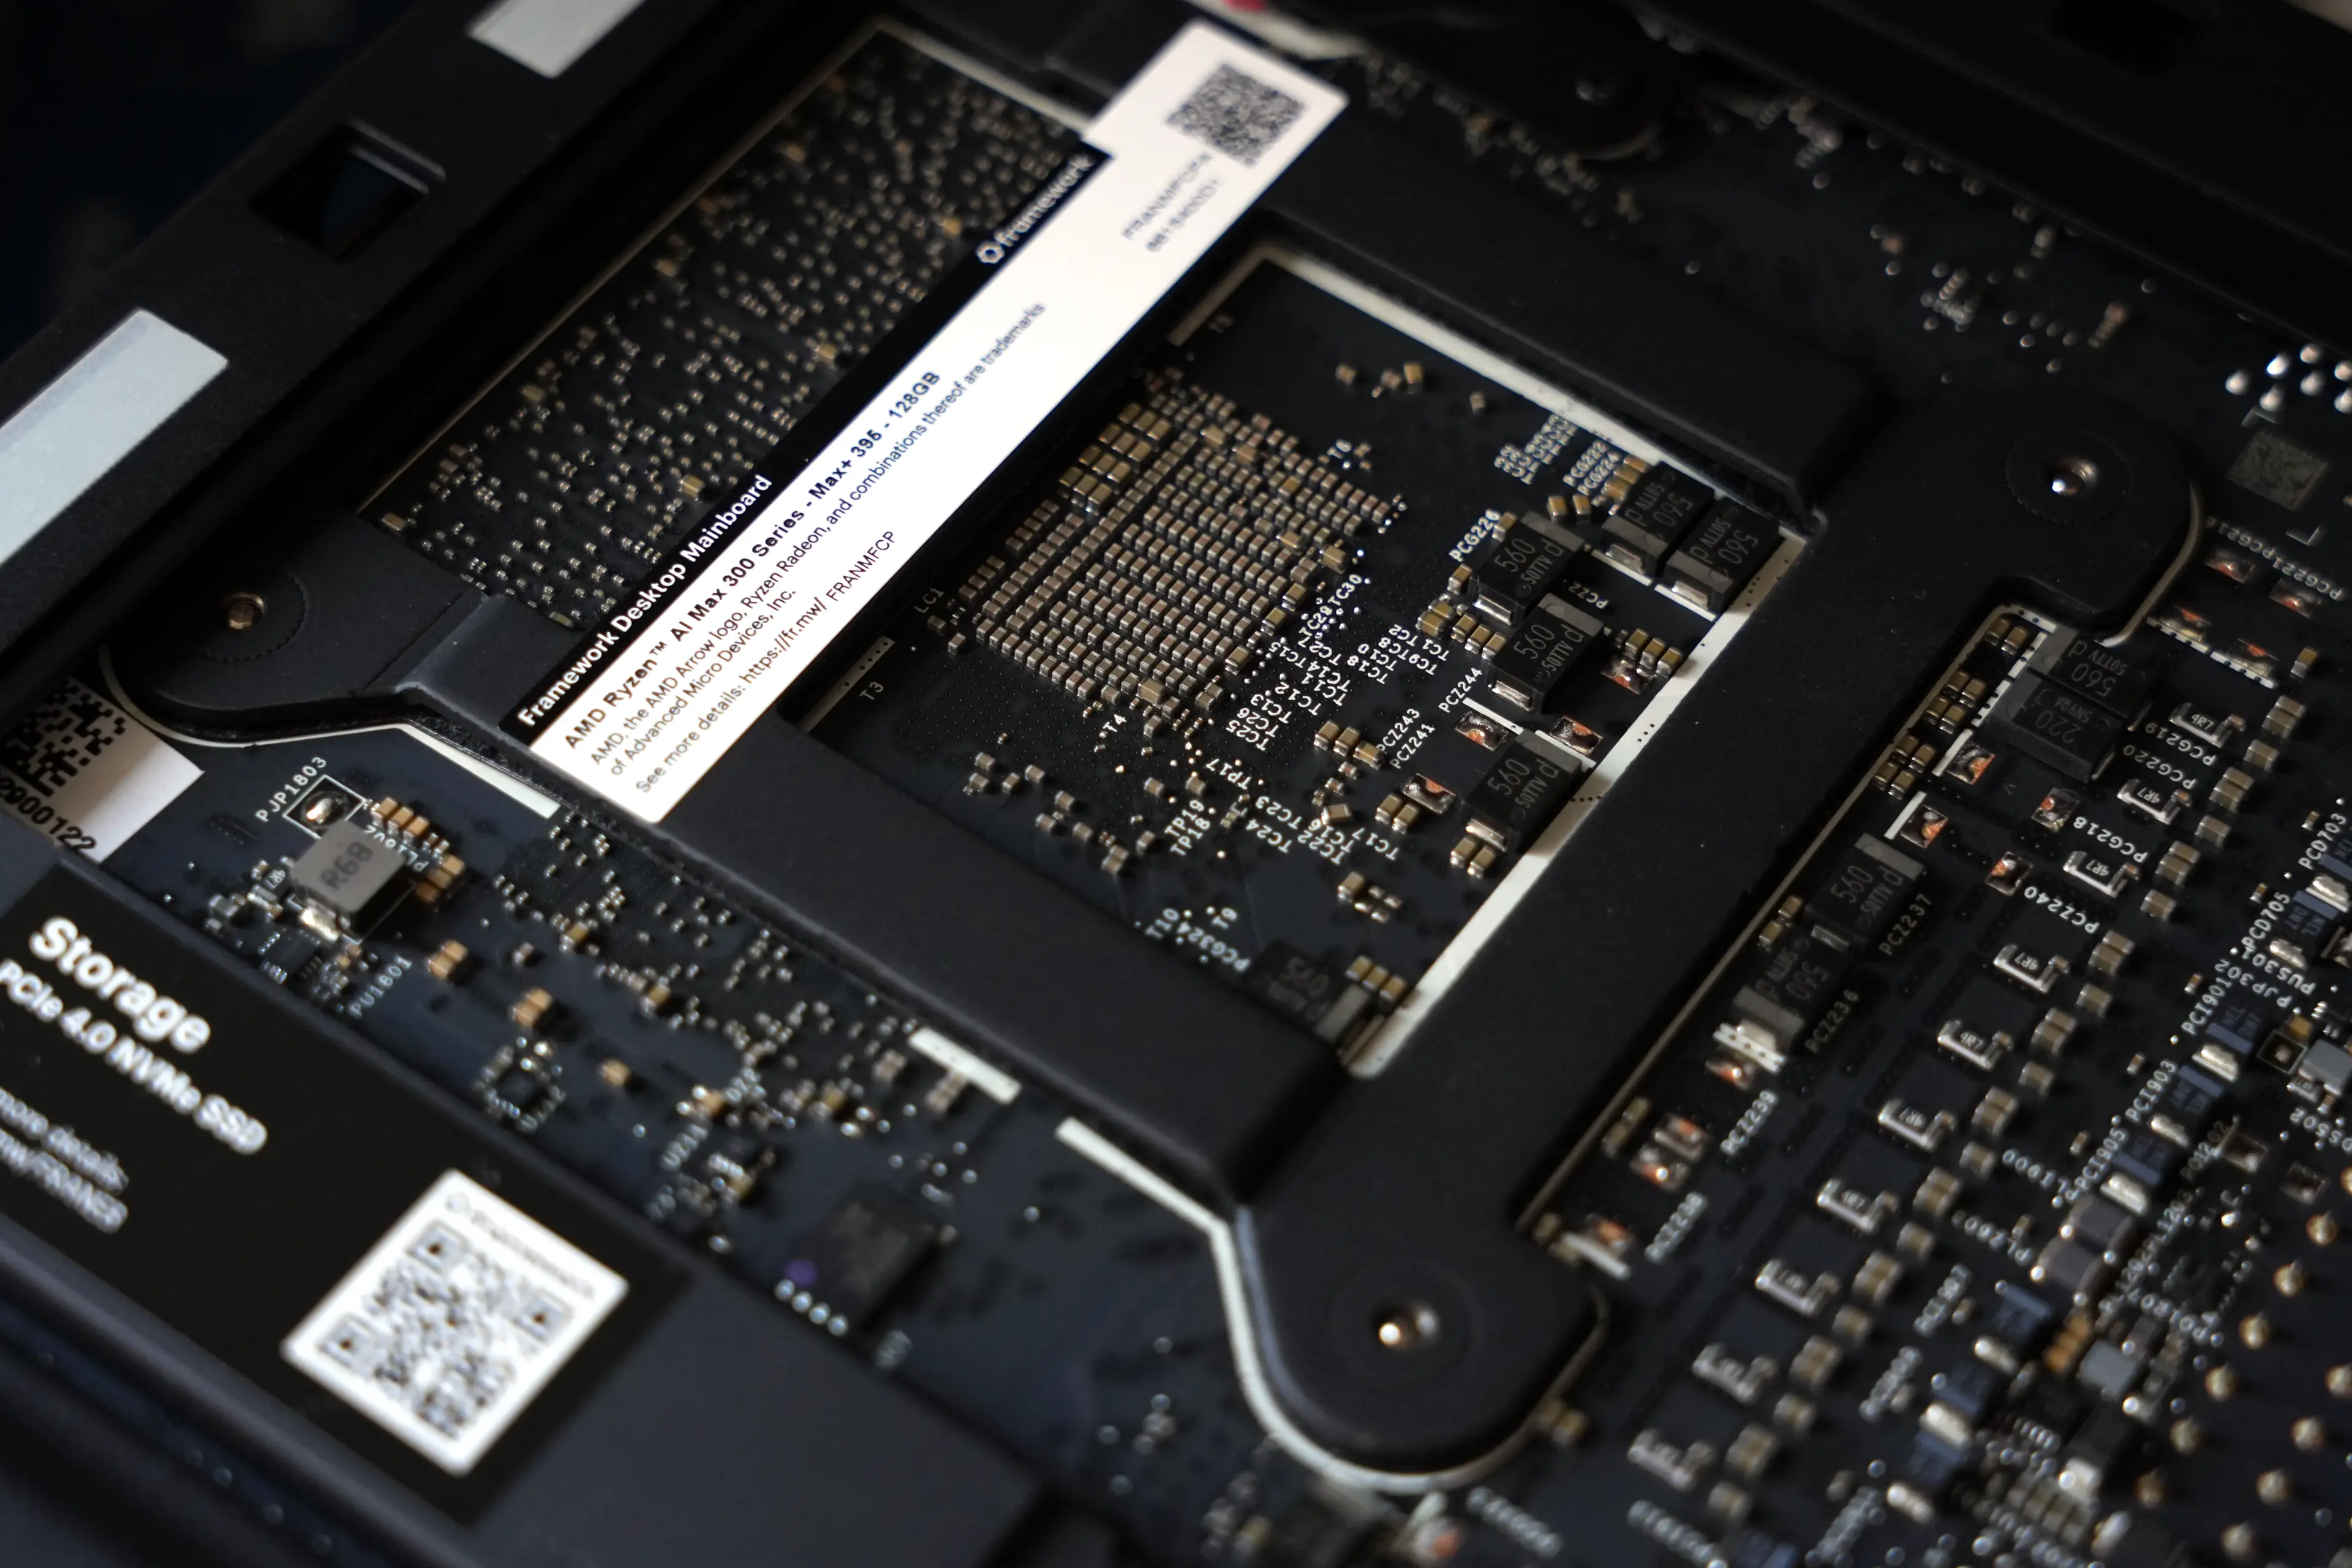
- Rechner
- Framework Desktop, AMD Ryzen AI Max 300 Serie, Revision A6
- Prozessor
- AMD Ryzen AI Max+ 395, 16 Kerne und 32 Threads, bis zu 5,19 GHz
- Grafik
- Integrierte AMD Radeon 8060S
- Speicher
- 128 GB gemeinsamer Speicher für Prozessor und Grafikeinheit
Die lokalen Modelle laufen auf einem Framework Desktop mit AMD Ryzen AI Max+ 395. Seine 128 GB gemeinsamer Speicher stehen Prozessor und Grafikeinheit zur Verfügung. So lassen sich größere Modelle laden, als es mit den meisten Grafikkarten für Privatanwender möglich wäre. Ein zweiter Rechner mit einer NVIDIA GeForce RTX 5070 Ti steuert die leichteren Modelle bei.
Beobachtete lokale Generierungsgeschwindigkeit (Strix Halo)
Median der auf der Strix-Halo-Maschine (Framework Desktop, Ryzen AI Max+ 395) erzeugten Tokens pro Sekunde über die dort generierten gültigen Benchmark-Antworten, einschließlich Reasoning-Tokens. Die Geschwindigkeit hängt von Kontextlänge und Software ab. Modelle ohne genügend Messungen auf Strix Halo sind nicht aufgeführt.
| Modell | Quantisierung | Median | Antworten |
|---|---|---|---|
| Gemma 4 26B A4B | Q8_0 | 39.8 Token/s | 465 |
| Gemma 4 E2B | Q4_K_M | 39.4 Token/s | 224 |
| Gemma 4 E4B | Q8_0 | 35.9 Token/s | 542 |
| Gemma 4 E2B | Q6_K | 33.2 Token/s | 216 |
| Ling 3.0 Flash | Q4_K_M | 31.6 Token/s | 277 |
| Ling 3.0 Flash | Q4_K_M | 30.5 Token/s | 240 |
| Gemma 4 E2B | Q8_0 | 29.2 Token/s | 224 |
| Gemma 4 26B A4B QAT | QAT-Q4_0 | 27.9 Token/s | 118 |
| Qwen3.6 35B A3B | Q4_K_M | 26.6 Token/s | 347 |
| Nemotron 3 Nano Omni | Q4_K_M | 25.1 Token/s | 960 |
| Gemma 4 E4B | Q4_K_M | 22.4 Token/s | 221 |
| Qwen3.6 35B A3B | Q8_0 | 22.1 Token/s | 312 |
| Nemotron 3 Nano Omni | Q8_0 | 21.2 Token/s | 391 |
| Nemotron 3 Super | Q4_K_M | 21.1 Token/s | 413 |
| Gemma 4 26B A4B | Q6_K | 20.2 Token/s | 539 |
| Gemma 4 E4B | Q6_K | 18.6 Token/s | 218 |
| Granite 4.2 8B | Q4_K_M | 16.9 Token/s | 36 |
| Gemma 4 12B | Q8_0 | 14.6 Token/s | 124 |
| Gemma 4 12B QAT | QAT-Q4_0 | 11 Token/s | 752 |
| Gemma 4 31B QAT | QAT-Q4_0 | 10 Token/s | 548 |
| Gemma 4 12B | Q6_K | 9 Token/s | 216 |
| Qwen3.8 27B | Q4_K_M | 8.9 Token/s | 546 |
| Muse Glimmer 30B Kquant 17gb | K-Quant 17GB | 8.8 Token/s | 394 |
| Qwen3.8 27B | Q8_0 | 8.4 Token/s | 498 |
| Muse Glimmer 30B Kquant Dynamic | K-Quant Dynamic | 8 Token/s | 397 |
| Granite 4.2 30B | Q4_K_M | 7.6 Token/s | 423 |
| Qwen3.6 27B | Q8_0 | 7.5 Token/s | 190 |
| Qwen3.8 27B | Q6_K | 7 Token/s | 504 |
| Granite 4.2 30B | Q6_K | 6.6 Token/s | 397 |
| Gemma 4 31B | Q6_K | 5.8 Token/s | 527 |
| Qwen3.6 27B | Q4_K_M | 5.2 Token/s | 588 |
| Granite 4.2 30B | Q8_0 | 4.9 Token/s | 447 |
| Gemma 4 31B | Q8_0 | 4.8 Token/s | 316 |
Vergleichbare veröffentlichte Benchmarks für Ryzen AI Max+ 395