Die Modelle werden nach der Qualität ihrer deutschen Texte geordnet. Mit den Filtern lässt sich die Liste eingrenzen. Für die ausgewählten Schreibkategorien werden die Ränge vor den Filtern für Anbieter, Größe, Zugang, Reasoning und Quantisierung berechnet; ausgeblendete Modelle können daher Lücken hinterlassen.
Zuletzt aktualisiert:
Rangliste der Schreibmodelle auf Basis paarweiser Ergebnisse
Rang
Modell
KI-
Bewertung
Menschliche
Bewertung
1
GPT-6.1 Sol 💡 high
96,5
—
2
GPT-6 Astra 💡 high
95,5
—
3
Claude Opus 5 💡 adaptive high
94,4
—
4
Claude Fable 5 💡 adaptive high
94,0
—
5
Claude Opus 5.5 💡 adaptive high
93,9
—
5
Kimi K3.1 Pro 💡 high
93,9
—
7
Claude Fable 5.1 💡 adaptive high
93,3
—
8
Claude Fable 5.2 💡 adaptive high
91,6
—
9
Gemini 4 Hydrogen 💡 high
91,3
—
10
Kimi K3 💡 enabled
91,2
—
11
Muse Spark 1.2 💡 high
89,6
—
12
GPT-6 Sol 💡 high
89,0
—
13
GPT-5.6 Sol 💡 high
88,9
—
13
GPT-6.1 Terra 💡 high
88,9
—
15
DeepSeek V4.1 Flash 💡 high
88,2
—
17
Grok 4.7 💡 high
87,4
—
18
Gemini 3.7 Flash 💡 medium
87,1
—
19
Gemini 3.8 Flash 💡 high
86,9
—
20
Claude Sonnet 5.5 💡 adaptive high
86,7
—
21
Muse Spark 1.3 💡 high
84,2
—
22
GLM 5.3 💡 max
83,6
—
23
Gemini 4 Argon 💡 high
82,6
—
24
Qwen3.8 Max 💡 xhigh
81,5
—
25
GPT-6 Luna 💡 high
80,7
—
26
Hy4 Preview 💡 high
79,7
—
28
Claude Haiku 5.5 💡 adaptive high
77,5
—
29
Claude Sonnet 5 💡 adaptive high
77,1
—
30
Qwen3.7 Max 💡 enabled
76,5
—
31
GPT-5.6 Terra 💡 high
76,4
—
32
GPT-5.6 Luna 💡 high
75,6
—
33
Aion 3.5 💡 high
74,7
—
34
Mistral Large 4 💡 high
72,5
—
35
Inkling 💡 high
71,0
—
36
Muse Ember 💡 high
69,5
—
37
Qwen4 Max 💡 high
68,3
—
38
Beam 1.0 💡 high
67,3
—
39
DeepSeek V4 Flash 💡 enabled
67,2
—
40
Ling 3.2 Flash 💡 high
66,9
—
41
MiniMax M3 💡 enabled
66,4
—
42
Gemma 4 31B Q8_0 💡 on* 🏠
66,3
57,2
43
Aion 3.0 💡 mandatory
66,2
—
44
Hy3 💡 high
65,0
—
45
GLM 5.2 💡 enabled
64,8
—
46
Gemma 4 26B A4B Q8_0 💡 on* 🏠
63,3
38,4
47
Step 5 Preview fp8 💡 high
62,9
—
49
MiMo V2.6 Pro fp8 💡 high
61,8
—
51
Qwen3.7 Plus 💡 enabled
60,9
—
53
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
59,3
—
57
MiMo V2.5 Pro 💡 enabled
56,9
—
58
DeepSeek V4 Pro 💡 enabled
56,3
—
60
Gemma 4 12B Q8_0 ↯ 🏠
55,7
—
60
Gemma 4 31B Q8_0 ↯ 🏠
55,7
—
62
Ling 3.1 Flash 💡 high
55,6
—
63
Qwen3.6 27B Q8_0 💡 on* 🏠
52,3
42,4
66
Nemotron 3.5 Super VL 💡 high
49,7
—
68
Qwen3.8 Flash 💡 high
48,8
—
69
Gemma 4 12B Q8_0 💡 on* 🏠
48,7
—
70
Mercury 3 💡 high
48,5
—
73
GLM 5.3 Flash 💡 high
45,9
—
74
Nemotron 3 Ultra 💡 high
45,4
—
75
Grok 4.6 💡 high
45,0
—
79
Gemma 4 26B A4B Q8_0 ↯ 🏠
43,4
—
81
Mistral Medium 3.5 💡 high
39,0
—
82
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
38,2
57,6
86
Seed 2.1 Turbo ↯
34,5
—
87
MiMo V2.6 Flash 💡 high
26,8
—
89
MiMo V2.5 💡 enabled
22,9
—
89
Agnes 3.0 Flash 💡 high
22,9
—
91
Qwen3.8 27B Q8_0 ↯ 🏠
22,7
—
92
Nemotron 3.5 Lightning 💡 high
20,1
—
95
Qwen3.6 27B Q8_0 ↯ 🏠
19,2
—
96
MiniMax M3.1 Flash 💡 high
19,0
—
97
Gemma 4 E4B Q8_0 💡 on* 🏠
17,3
—
99
Flint V1.0 💡 high
15,3
—
103
Gemma 4 E4B Q8_0 ↯ 🏠
11,3
—
104
Qwen3.6 35B A3B Q8_0 ↯ 🏠
11,2
—
107
Gemma 4 E2B Q8_0 💡 on* 🏠
10,2
—
110
Gemma 4 E2B Q8_0 ↯ 🏠
9,7
—
117
Granite 4.2 30B Q8_0 💡 full 🏠
5,0
—
118
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
4,7
—
121
Granite 4.2 8B Q8_0 💡 full 🏠
1,5
—
Für diese Auswahl liegt noch kein veröffentlichtes Ergebnis vor
Ein Modell erscheint nach seiner ersten veröffentlichten Einzelbewertung; sein Ranglistenwert nach seinem ersten zulässigen Duell.
121 verglichene Modelle · 135.341 veröffentlichte KI-Urteile
Methode: regularisiertes Bradley–Terry-Modell. Die KI-Bewertung bestimmt den Rang; die menschliche Bewertung ist davon unabhängig und bleibt nachrangig, bis mehr Stimmen aus dem Publikum vorliegen. Eine Bewertung von 50 bedeutet, dass ein Modell das durchschnittliche Modell dieser Sprache und Kategorie schätzungsweise in der Hälfte der Duelle schlägt.
Ergebnisse der direkten Duelle
Jede Zelle zeigt den Anteil der möglichen Punkte, den das Zeilenmodell gegen das Spaltenmodell erzielt: Ein Sieg zählt 100 %, ein Unentschieden 50 %, eine Niederlage 0 %. Diese Ergebnismatrix verwendet nur die mit der Hauptrangliste kompatiblen Bewertungsprotokolle.
Gerichtete Matrix der in direkten Duellen erzielten Punkte. Werte über 50 % sprechen für das Zeilenmodell, Werte darunter für das Spaltenmodell.
0 %100 %
💡 kennzeichnet ein Modell mit Reasoning, ↯ eines ohne Reasoning. 🏠 kennzeichnet ein Modell, das lokal ausgeführt wurde: auf dem Rechner des Autors dieser Website.„on*“ bedeutet, dass sich Reasoning nur ein- oder ausschalten lässt (lokale Modelle ohne Zwischenstufen): Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf den standardmäßig aktivierten Modus zurück. Bei lokalen Modellen mit einstellbarem Reasoning (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash) ist das angezeigte Niveau (xhigh**, high, full) das Standardniveau des Modells: Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf ihr Standardverhalten zurück.
Als Tabelle anzeigen
In direkten Duellen erzielte Punkte je Modellpaar
Modell
Abdeckung der veröffentlichten Duelle
Jede Zelle zeigt, wie viele veröffentlichte, KI-bewertete Duelle über alle Protokolle hinweg die beiden Modelle für diese Sprache und Kategorie vergleichen. Die Modelle auf beiden Achsen sind Kandidaten; die Matrix zeigt nicht, welcher Juror das jeweilige Urteil gefällt hat.
Symmetrische Matrix der veröffentlichten Duellzahlen. Die Diagonale ist null, weil ein Modell nicht mit sich selbst verglichen wird.
0
💡 kennzeichnet ein Modell mit Reasoning, ↯ eines ohne Reasoning. 🏠 kennzeichnet ein Modell, das lokal ausgeführt wurde: auf dem Rechner des Autors dieser Website.„on*“ bedeutet, dass sich Reasoning nur ein- oder ausschalten lässt (lokale Modelle ohne Zwischenstufen): Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf den standardmäßig aktivierten Modus zurück. Bei lokalen Modellen mit einstellbarem Reasoning (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash) ist das angezeigte Niveau (xhigh**, high, full) das Standardniveau des Modells: Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf ihr Standardverhalten zurück.
Als Tabelle anzeigen
Veröffentlichte Duelle je Modellpaar
Modell
Helfen Sie mit, das beste Schreibmodell für Deutsch zu küren
Welches Modell schreibt den besseren Text? Beurteilen Sie dieses anonyme Paar und tragen Sie zur menschlichen Rangliste bei. Im Textduell sehen Sie nicht, welches Modell welchen Text geschrieben hat. Die Namen erscheinen erst nach Ihrer Wahl.
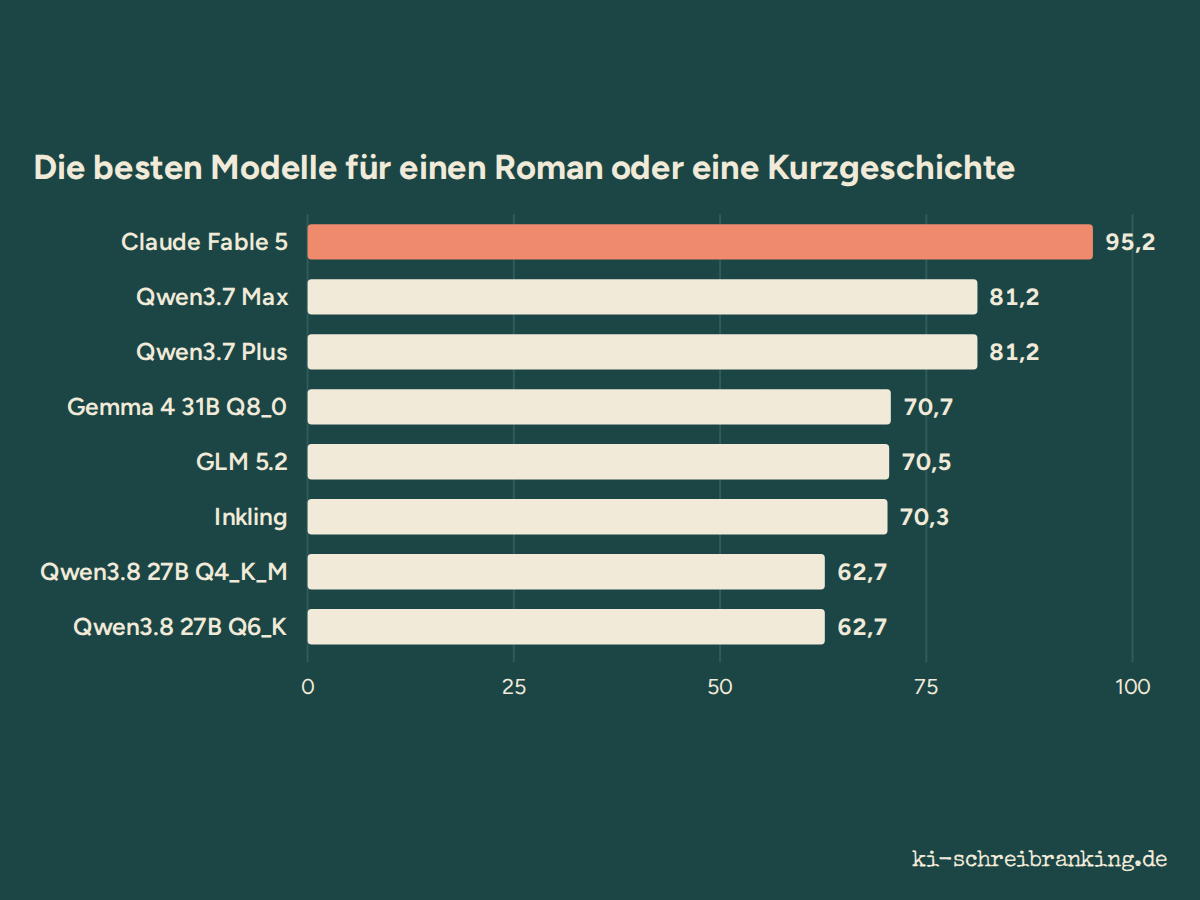
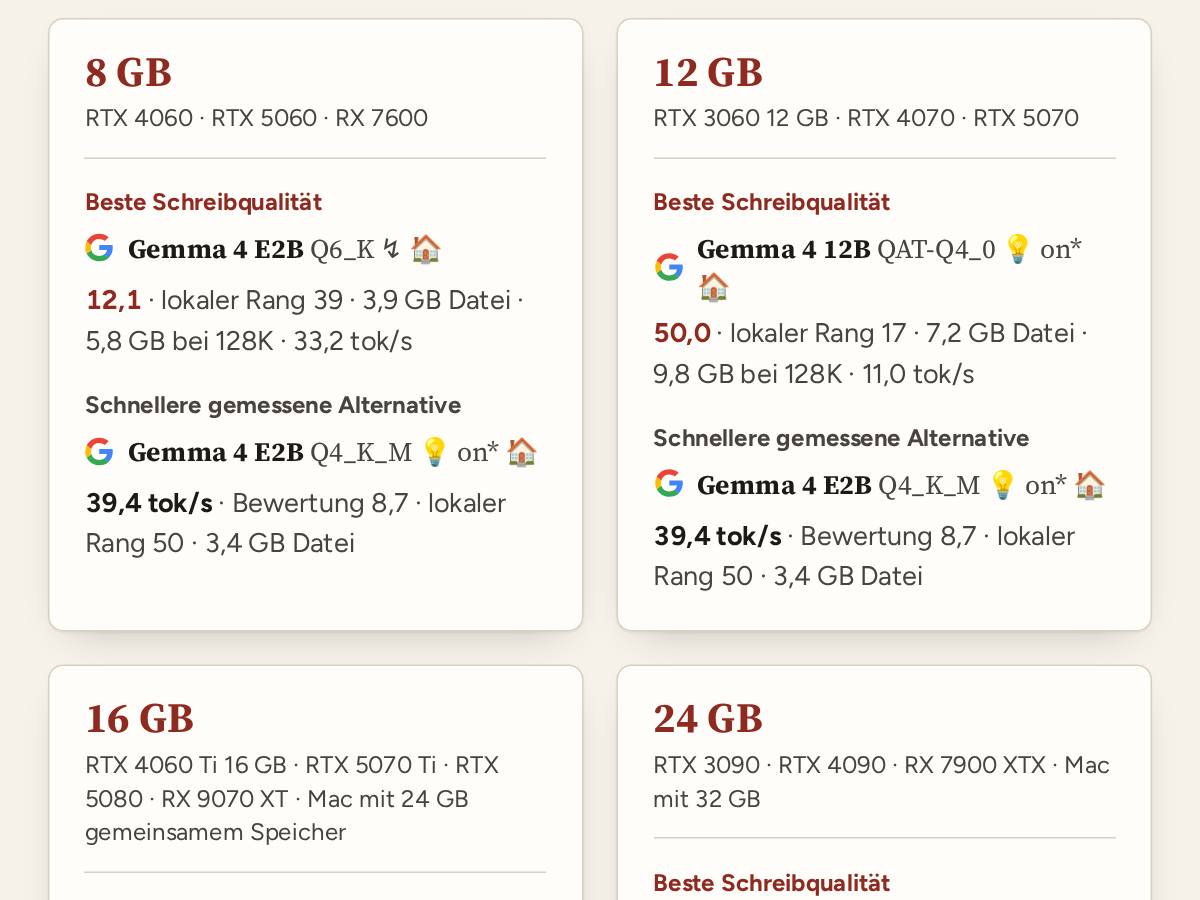
Die Rangliste hat einen Sieger; Ihre Texte haben viele. Allein auf den Duellen einer Textsorte gewinnt Claude Fable 5 Fiktion und Erklärung, Claude Opus 5 persönliche Briefe, und bei Bewerbungen liegen Claude Fable 5 und GPT-5.6 Sol gleichauf. Ein einfacher Leitfaden, Aufgabe für Aufgabe, mit der besten Datei für den eigenen Rechner.
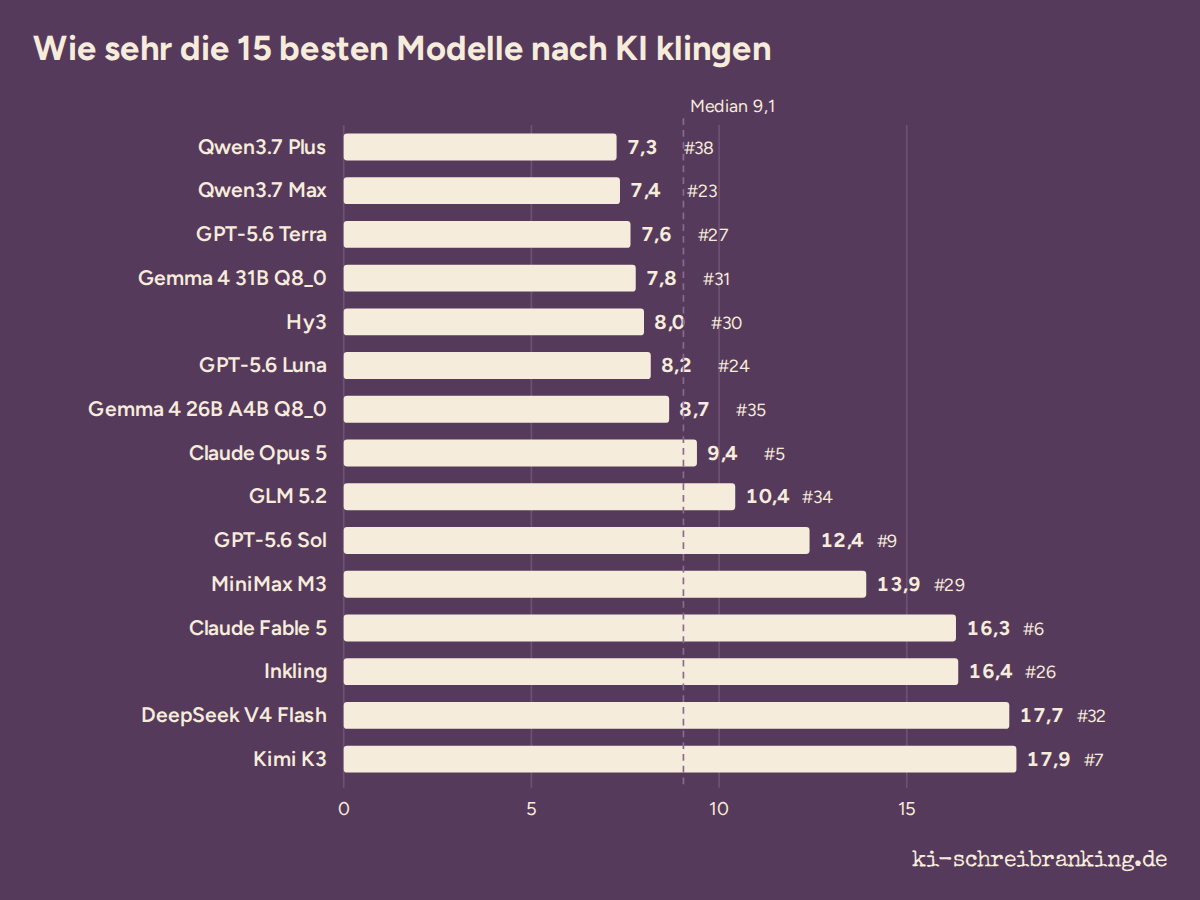
Wir haben in 3.182 gewerteten deutschen Texten gezählt, was Leser „KI-Prosa“ nennen: Gedankenstriche, Floskeln, „nicht X, sondern Y“, Dreierlisten, Anglizismen. Kimi K3 und Claude Fable 5, damals Platz 5 und 3, setzen alle 70 bis 80 Wörter einen Gedankenstrich; Claude Opus 5, damals Erster, deutlich seltener. Und „zudem“ steht 257-mal im Korpus.
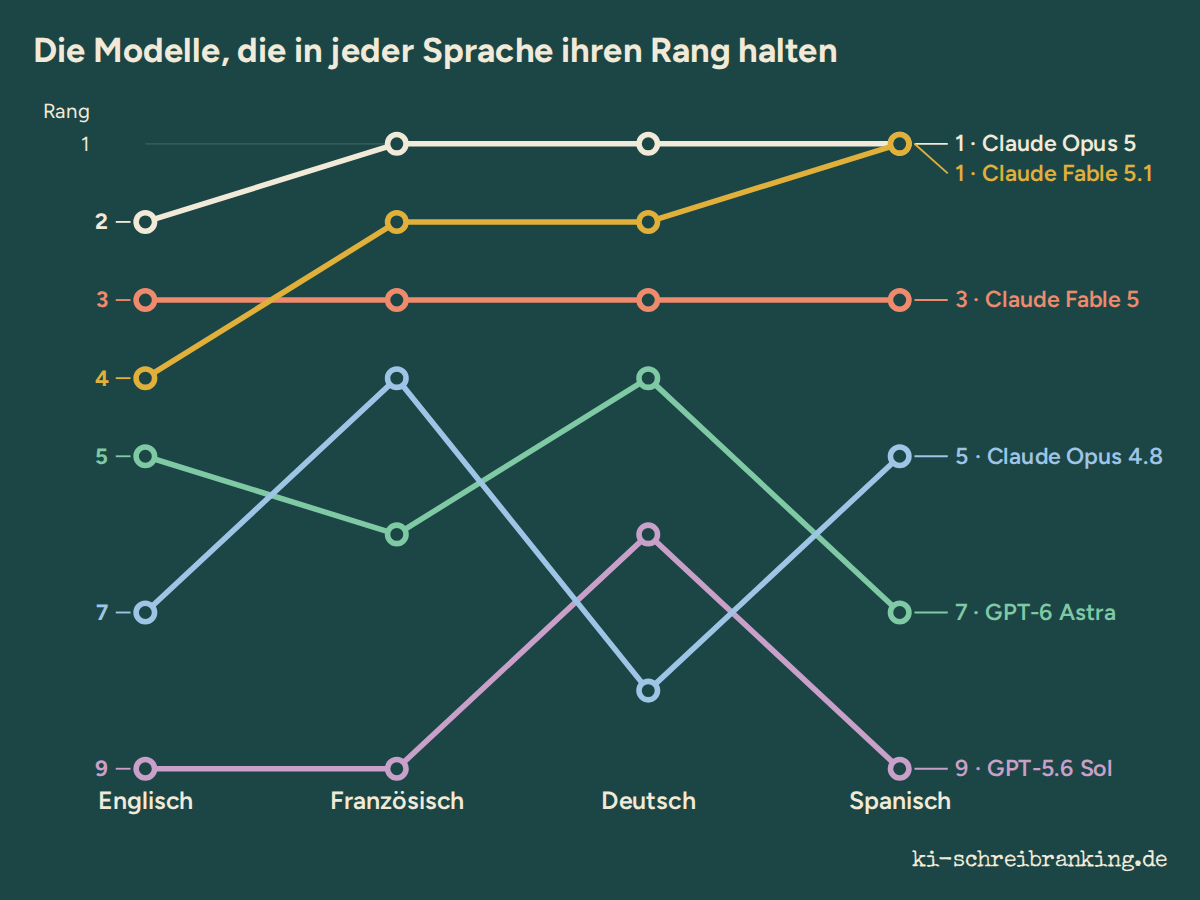
91 Modelle sind auf Englisch, Französisch, Deutsch und Spanisch nach demselben Verfahren eingestuft. Am 19. September war Claude Fable 5 in allen vier Sprachen Dritter, Claude Opus 5 auf Deutsch Erster. Darunter war GLM 5.3 Flash auf Englisch Zehnter und auf Deutsch 54., und die beste lokale Datei ist in jeder Sprache eine andere: auf Deutsch Gemma 4 31B.
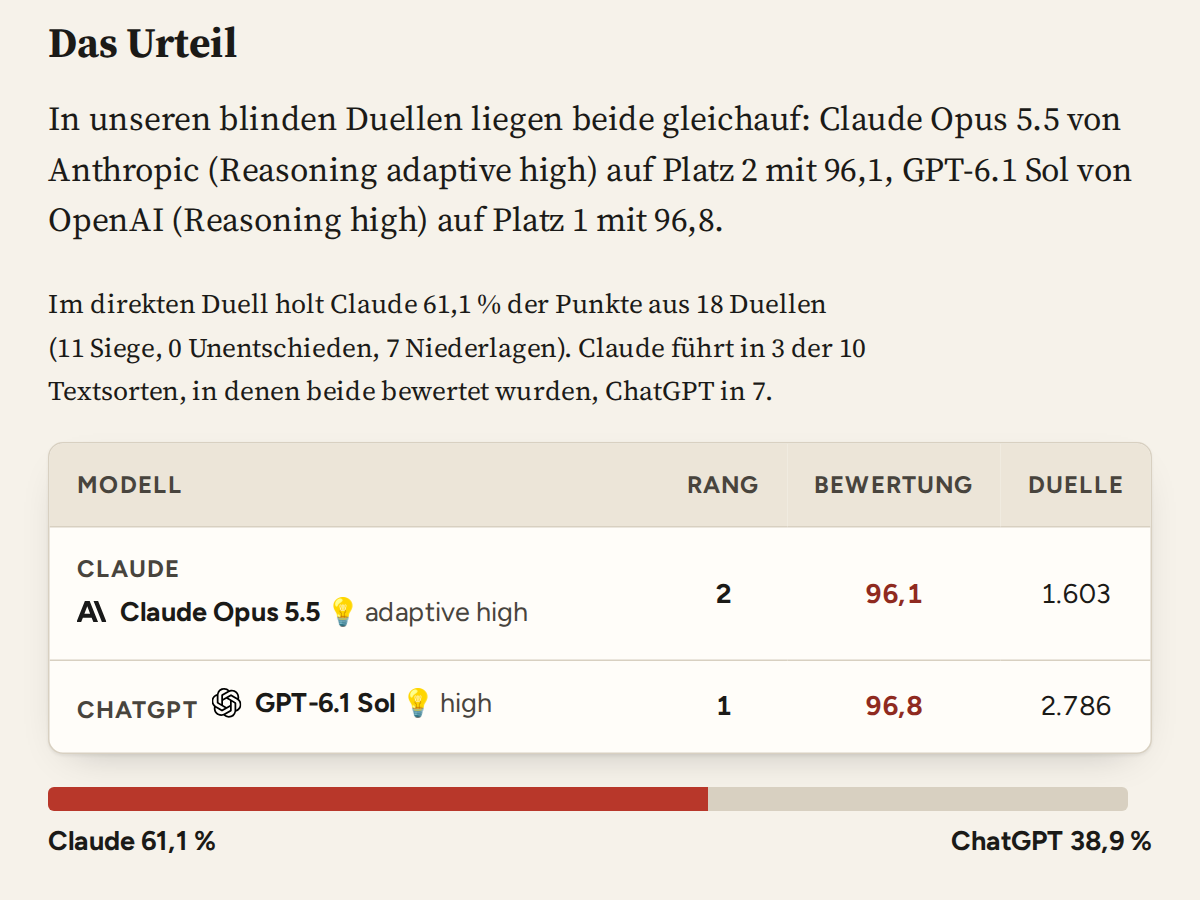
Die beiden meistgefragten Assistenten, auf denselben deutschen Aufgaben in blinden Duellen beurteilt: wer besser schreibt, um wie viel, und bei welchen Textsorten. Mit jeder Aktualisierung der Rangliste neu berechnet.